
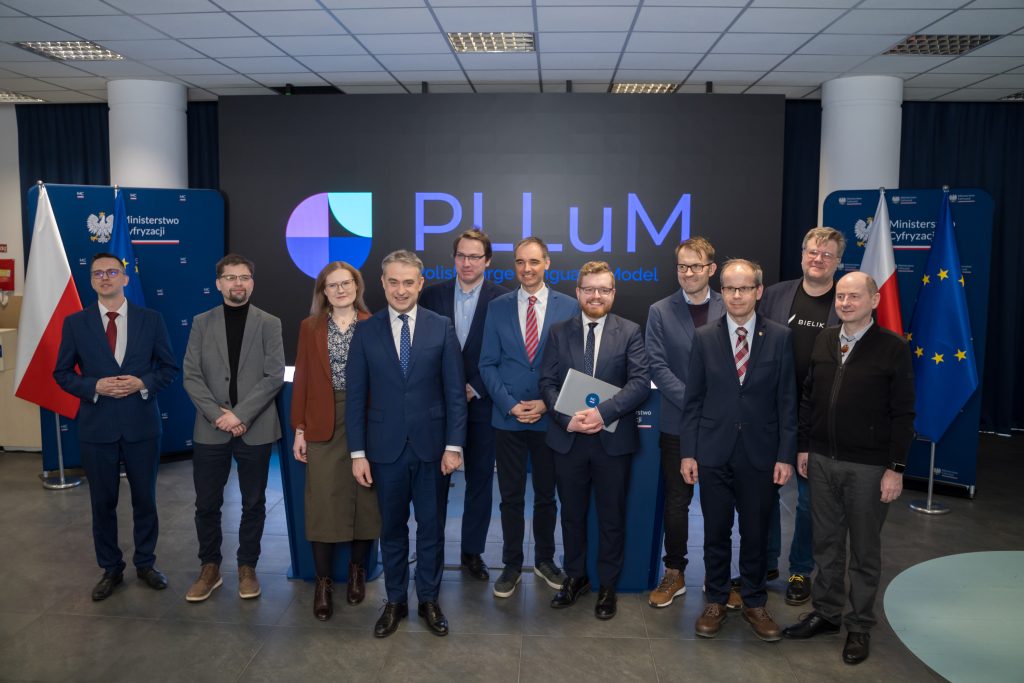
Prawie 19 mln zł będzie kosztować realizacja projektu HIVE AI. Ma on na celu pilotażowe wdrożenie dużych polskich modeli językowych w usługach administracji publicznej, m.in. w aplikacji mObywatel, w roli asystenta dla Ministerstwa Cyfryzacji oraz w wybranych urzędach.
HIVE AI to kontynuacja projektu PLLuM (Polish Large Language Model), który obecnie przechodzi z fazy badań do wdrożeń. Jego celem było stworzenie otwartego polskiego modelu językowego zgodnie z założeniami odpowiedzialnego rozwoju sztucznej inteligencji. Ma on służyć nie tylko naukowcom i przedsiębiorcom, ale całemu społeczeństwu.
Generatywne modele językowe (LLM), takie jak ChatGPT czy Google Bard, mają istotne ograniczenia – są dostępne za opłatą oraz działają w trybie zamkniętym, co uniemożliwia poznanie i modyfikację ich algorytmów. Istotnym aspektem jest również fakt, że trening tych modeli odbył głównie na materiałach anglojęzycznych, co prowadzi do większej liczby błędów w udzielanych odpowiedziach po polsku. To właśnie te niedoskonałości zainspirowały powstanie otwartego i darmowego modelu opartego na treściach w języku polskim. PLLuM (Polish Large Language Model) to rodzina modeli sztucznej inteligencji stworzonych przez polskich ekspertów i ekspertki z dziedziny IT i lingwistyki.
PLLuM to dowód na to, że możemy rozwijać nowoczesne technologie na własnych warunkach, w naszym języku, z korzyścią dla obywatelek i obywateli. Tworzymy fundament pod inteligentne usługi publiczne i innowacje, które będą realnym wsparciem zarówno dla administracji, jak i biznesu – mówi wicepremier i minister cyfryzacji Krzysztof Gawkowski.
Polski model językowy jest elastyczny i skalowalny – wykorzystuje od 8 do 70 miliardów parametrów. Pozwala na precyzyjne generowanie treści w języku polskim. Mniejsze wersje dobrze sprawdzają się w szybkich zadaniach, podczas gdy większe modele oferują wyższą precyzję i kontekstową spójność w rozumieniu języka polskiego. W rodzinie modeli PLLuM znajdują się m.in. modele w architekturze MoE (ang. Mixture of Experts) ze zrównoważonym wyborem ekspertów oraz wyspecjalizowane modele RAG (ang. Retrieval Augmented Generation).
PLLuM bazuje na etycznym pozyskiwaniu danych – wersje do użytku komercyjnego wykorzystują zasoby tekstowe od właścicieli, którzy udzielili licencji konsorcjum, a także zasoby, które, zgodnie z ustawą o prawie autorskim i prawach pokrewnych oraz przepisami UE, mogą być wykorzystane do budowy w pełni otwartego modelu. Modele naukowe (tj. udostępniane na licencjach, które nie pozwalają na zastosowania komercyjne) korzystają także z ogólnodostępnych zbiorów danych, takich jak Common Crawl. PLLuM dostrajany jest na autorskich zbiorach danych, czyli dziesiątkach tysięcy tzw. instrukcji – pobudzeń (promptów) i oczekiwanych odpowiedzi modelu – oraz preferencji – pobudzeń i różnych odpowiedzi modeli ocenionych pod kątem jakościowym – tworzonych przez zespół ponad 50 specjalistów i specjalistek.
Do tej pory przeznaczyliśmy na ten projekt 14,5 mln zł, a teraz idziemy krok dalej – kolejne 19 mln zł pozwoli na wdrożenie modelu w administracji publicznej i rozszerzenie współpracy o nowych partnerów, takich jak COI i Cyfronet. Dzięki temu PLLuM stanie się kluczowym elementem cyfryzacji usług publicznych i rozwoju krajowego ekosystemu AI – zapowiada wiceminister cyfryzacji Dariusz Standerski.
W projekcie realizowanym na zlecenie Ministerstwa Cyfryzacji uczestniczyło do tej pory sześć instytucji: Politechnika Wrocławska (lider), Instytut Podstaw Informatyki PAN, Instytut Slawistyki PAN, Naukowa i Akademicka Sieć Komputerowa (NASK-PIB), Ośrodek Przetwarzania Informacji (OPI-PIB), Uniwersytet Łódzki. Teraz dołączają dwie kolejne: Centralny Ośrodek Informatyki i ACK CYFRONET AGH.
Zaplanowane dla ośmiu powołanych instytucji naukowych działania obejmą wdrożenie modeli językowych w administracji, m.in. w aplikacji mObywatel, w roli asystenta dla Ministerstwa Cyfryzacji oraz w wybranych urzędach Ponadto przewidziano dostosowanie i rozwój modeli językowych poprzez zebranie nowych danych, stworzenie specjalnych – dostosowanych do potrzeb urzędów – instrukcji, a także opracowanie modeli ogólnego zastosowania i wyspecjalizowanie generatorów odpowiedzi.
Projekt HIVE AI składać się będzie z czterech etapów: budowy korpusów danych językowych do bazowego treningu, treningów dużych modeli językowych, ewaluacji oraz pilotażowego wdrożenia modeli w sektorze publicznym. Prace potrwają do końca 2025 roku.
MK, źródło: MC, PAN